AI-dokumentumfeldolgozás: papírból és PDF-ből rögzített adat.
Az AI kiolvassa a számlákat, szerződéseket és ajánlatokat, ellenőrzi az adatokat, és rögzíti őket a rendszereiben. Ember csak a bizonytalan eseteket nézi át.
- Magyar nyelvű dokumentumokra is
- Ellenőrzés üzleti szabályokkal
- Titkosított tárolás
Szemléltető példa – nem ügyféladat.
Ismerős helyzet?
Így szokott kezdődni – és ezekre a helyzetekre építjük a megoldást.
Így oldjuk megHavonta több száz számlát gépelek be kézzel – és a végén még egyeztetni is kell.
⚠ Kézi gépelésMikor jár le a keretszerződés felmondási ideje? Valahol benne van a PDF-ben…
⚠ Rejtve maradó határidőkMinden szállító másképp küldi: szkennelve, fotózva, angolul, németül.
⚠ Változatos formátumokAmit a megoldás elvégez
A beérkezéstől a rögzítésig végigvisszük a dokumentumot – a formátumtól függetlenül.
Beérkeztetés
E-mail-fiókból, szkennerből, portálról vagy API-n – egy helyre, titkosítva.
Szövegfelismerés
Szkennelt és fotózott dokumentumok is: szöveg, táblázatok, űrlapmezők.
AI-kinyerés
Mezők, összegek, tételsorok, dátumok – sablon nélkül, változó elrendezésben is.
Ellenőrzés
Megrendeléssel, törzsadatokkal és szabályokkal egyeztetve, megbízhatósági küszöbbel.
Rögzítés
ERP-be, könyvelésbe, dokumentumtárba – API-n, a meglévő folyamatba illesztve.
Kereshető archívum
Minden dokumentum tartalom szerint visszakereshető, jogosultság szerint.
Egy dokumentum útja
A beérkezéstől a rögzített, visszakereshető adatig.
 szemléltető
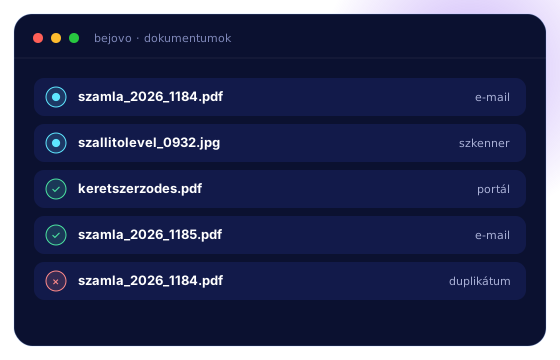
Beérkeztetés egy helyre
A dokumentumok bárhonnan érkezhetnek – e-mail-fiókból, szkennerből, partneri portálról. Egy titkosított tárba kerülnek, egyedi azonosítóval és teljes előzménnyel.
- E-mail, szkenner, portál, API
- Titkosított, verziózott tárolás
- Duplikátumszűrés
 szemléltető
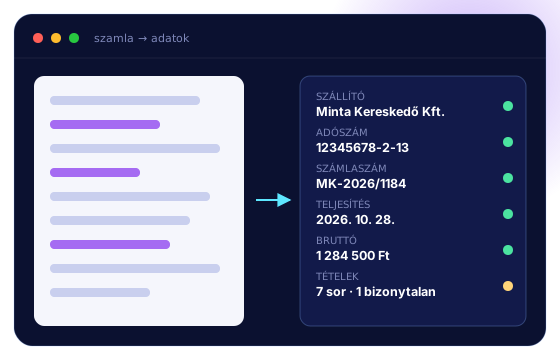
Kinyerés sablon nélkül
A szövegfelismerés után a nyelvi modell a tartalom alapján azonosítja a mezőket: szállító, adószám, dátumok, összegek, tételsorok. Egy új elrendezés vagy egy új partner sem igényel külön fejlesztést.
- Fejléc- és tételadatok
- Magyar és idegen nyelvű dokumentumok
- Mezőnkénti megbízhatósági érték
 szemléltető
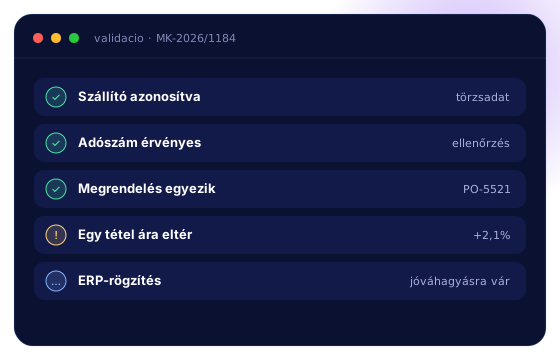
Ellenőrzés és rögzítés
A kinyert adatokat a rendszer összeveti a megrendeléssel, a törzsadatokkal és az üzleti szabályokkal. Ami megfelel, automatikusan rögzül az ERP-ben; ami nem, ellenőrzésre kerül.
- Háromutas egyeztetés (megrendelés – szállítólevél – számla)
- Adószám- és törzsadat-ellenőrzés
- Automatikus rögzítés API-n
 szemléltető
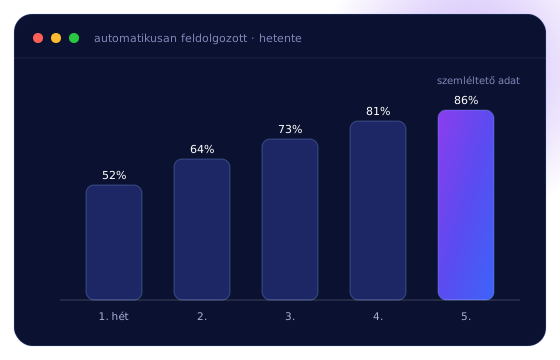
Emberi ellenőrzés, csak ahol kell
A bizonytalan mezőket a kolléga egy egyszerű felületen látja, a dokumentum mellett kiemelve. A javítás után a rendszer rögzít, és a visszajelzés a pontosság javítását szolgálja.
- Kiemelt bizonytalan mezők
- Egyképernyős ellenőrzés
- Visszajelzés a pontosság javításához
Így épül fel a dokumentumfeldolgozás
A dokumentum titkosított tárba érkezik, az AI kinyeri és ellenőrzi az adatokat, a megbízható eredmény automatikusan a célrendszerbe kerül, a bizonytalan pedig emberhez.
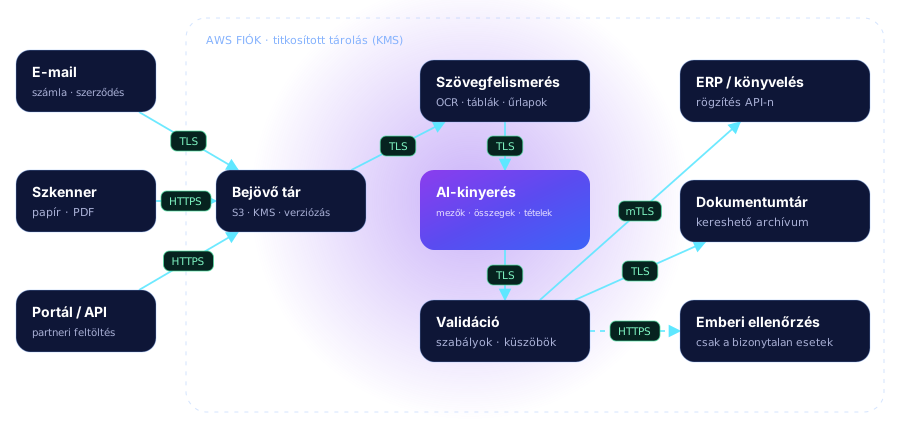
Egy számla útja – ma és AI-jal
- Letöltés, megnyitás, kézi gépelés
- Ellenőrzés papíron vagy táblázatban
- Elgépelés, utólagos javítás
- A dokumentum egy mappában marad
- Automatikus beérkeztetés és kinyerés
- Egyeztetés a megrendeléssel és a törzsadatokkal
- Csak a bizonytalan mező kerül emberhez
- Tartalom szerint kereshető archívum
Milyen dokumentumokra?
Szállítói számlák
Fejléc- és tételadatok, egyeztetés a megrendeléssel.
Szerződések
Felek, határidők, felmondási feltételek, kötelezettségek kigyűjtése.
Ajánlatkérések
A beérkező igények strukturált táblába, ajánlat-előkészítéshez.
Szállítólevelek és CMR
Tételek, mennyiségek, eltérések rögzítése.
Önéletrajzok és dokumentumok
Adatkinyerés, hiánypótlás.
Kérelmek és űrlapok
A kitöltött űrlapok adatai közvetlenül a rendszerbe.
Saját projektünk
Tenderárazás generatív AI-jal
Kihívás
Évente mintegy 250 tender, ajánlatonként 6–8 óra kézi munka.
Megoldás
A képletek ellenőrzése, az ajánlatok feldolgozása és az ütemterv generatív AI-jal (Amazon Bedrock), a cég saját AWS-fiókjában.
Eredmény
Ajánlatonként 1–2 óra (kb. 75%-kal kevesebb), évente mintegy 1000–1500 felszabaduló mérnökóra.
Így működik másoknál
Más cég nyilvánosan közzétett esete – a módszert mutatja, nem a mi munkánkat.
Dokumentum-AI elkülönített ügyfélkörnyezetekkel
Kihívás
Érzékeny dokumentumok több ezer ügyfélnek, szigorú elkülönítéssel.
Megoldás
Amazon Bedrock, munkamenetenként dedikált microVM, be- és kimeneti szűrés.
Eredmény
A közzétett adatok szerint 50%-kal rövidebb bevezetés felhasználási esetenként.
Négy lépés a működő megoldásig
Minták gyűjtése
valós dokumentumok, mezők, szabályok
Prototípus
pontosság mérése a saját dokumentumain
Integráció
ERP, könyvelés, dokumentumtár
Finomhangolás
küszöbök, új dokumentumtípusok
Amiből építkezünk
Felismerés
- Amazon Textract
- Többnyelvű OCR
AI
- Amazon Bedrock
- Anthropic Claude
Tárolás
- Amazon S3 · KMS
- Amazon OpenSearch
Integráció
- ERP- és könyvelési API
- E-mail és SFTP
Érzékeny dokumentumokhoz tervezve
- Titkosított tárolás és átvitel (KMS, TLS)
- Az adat a saját környezetében marad
- A bizonytalan eseteket ember ellenőrzi
- Minden kinyert mező visszakövethető a forrásig
Gyakori kérdések
Milyen pontos a kinyerés?
A pontosság a dokumentumok minőségétől és változatosságától függ, ezért a prototípus során a saját dokumentumain mérjük. A megbízhatósági küszöb alatti mezőket a rendszer emberi ellenőrzésre küldi, így a bizonytalan adat nem kerül ellenőrzés nélkül a rendszerbe.
Kezeli a magyar nyelvű és a szkennelt dokumentumokat?
Igen. A szövegfelismerés és a nyelvi modellek a magyar dokumentumokat is kezelik; szkennelt és fotózott anyagoknál a képminőség számít.
Minden partnerhez külön sablon kell?
Nem. A nyelvi modellek sablon nélkül, a tartalom alapján ismerik fel a mezőket, így egy új formátum sem igényel külön fejlesztést.
Hová kerülnek a dokumentumok?
A saját környezetébe – AWS-fiókba, Azure-előfizetésbe vagy saját szerverre –, titkosított tárba. A hozzáférést jogosultságok szabályozzák, és minden művelet naplózott.
Beszéljük át az Ön helyzetét
Egy kötelező kérdés, a neve és az e-mail-címe – a többi mező nem kötelező.
- Átnézzük a válaszait.
- Kollégánk felveszi Önnel a kapcsolatot, és egy rövid hívásban pontosítjuk a célokat.
- Konkrét javaslatot adunk az első lépésre.