AWS-monitoring: előbb tudja meg, mint az ügyfelei.
Metrikák, naplók és trace-ek egy helyen, üzleti szempontú SLO-k és értelmes riasztások – kiépítjük a megfigyelést, hogy a hiba ne a felhasználóknál derüljön ki.
- SLO-alapú riasztás
- A meglévő eszközeire építve
- Átadás a csapatának vagy üzemeltetés nálunk
Szemléltető példa – nem ügyféladat.
Ismerős helyzet?
Így szokott kezdődni – és ezekre a helyzetekre építjük a megoldást.
Így oldjuk megAz ügyfelek írják, hogy nem megy a fizetés. Tudunk róla?
⚠ Az ügyféltől derül kiÉjjel 200 riasztás jött, ebből egy volt fontos.
⚠ Riasztás-zajHol vannak a tegnapi naplók? Három helyen kerestem már.
⚠ Szétszórt naplókAmit kiépítünk
A jelzések gyűjtésétől az értelmes riasztásig. A folyamatos ügyeletet az AWS-felügyelet csomagjaink adják.
Teljes megfigyelés
Metrikák, naplók és trace-ek egy helyen, minden rétegben.
SLO-k
Üzleti szempontú célok: rendelkezésre állás, válaszidő, hibaarány.
Értelmes riasztás
Riasztás a felhasználói hatásra, nem minden apró eltérésre.
Eszkalációs rend
Ki kap riasztást, mikor és milyen sorrendben – dokumentálva.
Automatikus hibaelhárítás
Runbookok: újraindítás, skálázás, átterhelés automatikusan.
Dashboardok és átadás
Üzleti és technikai nézetek, dokumentáció és tudásátadás a csapatának.
A kiépítés lépésről lépésre
A láthatóságtól a megelőzésig.
 szemléltető
Jelzések gyűjtése
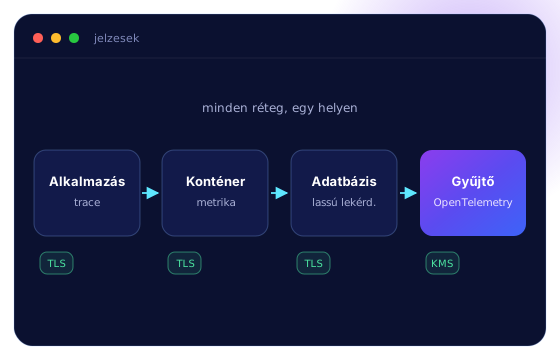
Minden rétegből – infrastruktúra, konténerek, adatbázisok, alkalmazások – egységesen gyűjtjük a metrikákat, naplókat és trace-eket, egy központi, titkosított helyre.
- OpenTelemetry és CloudWatch
- Központi naplók
- Elosztott trace-ek
 szemléltető
SLO-k és riasztás
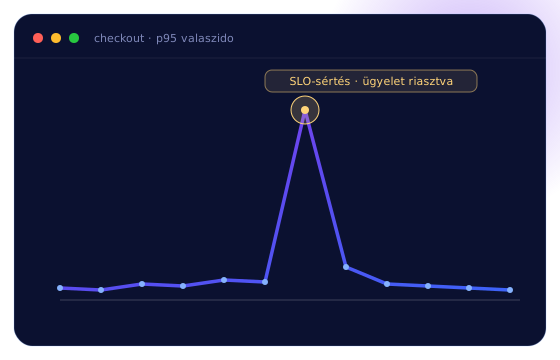
Üzleti szempontú célokat határozunk meg – például a fizetés rendelkezésre állása és válaszideje –, és akkor riasztunk, ha a felhasználói élmény romlik. Kevesebb zaj, gyorsabb reakció.
- Üzleti SLO-k
- Hibakeret (error budget)
- Zajcsökkentés
 szemléltető
Eszkaláció és automatikus javítás
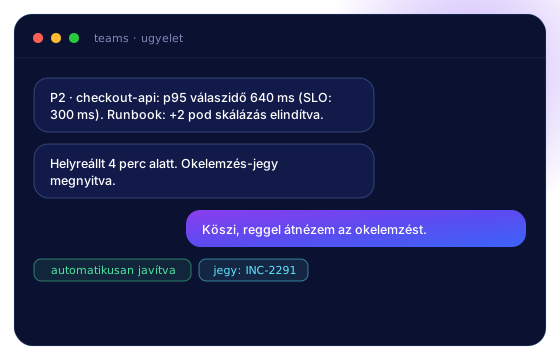
A riasztás a felelőshöz kerül, egyértelmű eszkalációs renddel; az ismert hibákat runbook javítja automatikusan. Ha az ügyeletet is ránk bízná, az AWS-felügyelet csomagjaink ezt átvállalják.
- Eszkalációs rend
- Runbook-automatizmus
- Ügyelet az AWS-felügyelet csomagban
 szemléltető
Okelemzés és megelőzés
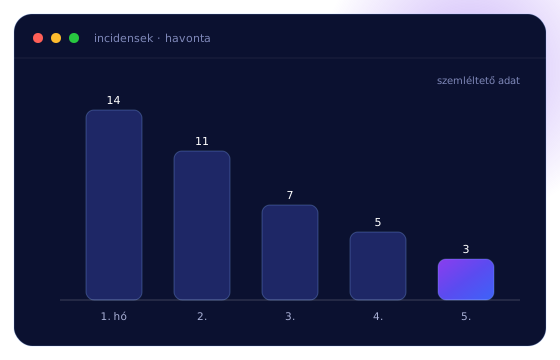
Az incidensekből okelemzés és megelőző javítás lesz; a dashboardok megmutatják a trendeket és a visszatérő hibákat.
- Hibáztatás nélküli okelemzés
- Megelőző javítások
- Trendek a dashboardon
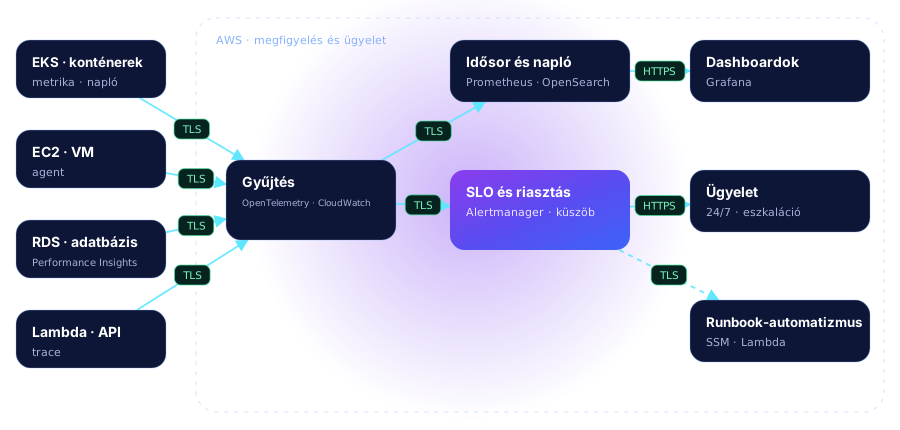
A megfigyelési lánc
Minden rétegből titkosítva gyűjtjük a jelzéseket; az SLO-k alapján riasztunk a felelősnek, az ismert hibákat runbook javítja automatikusan.
Üzemeltetés – reaktívan és proaktívan
- A hibáról az ügyfél szól
- Éjjeli riasztásáradat, fontos jelzés nélkül
- Naplók szétszórva, keresgélés
- Ugyanaz a hiba újra és újra
- Riasztás, mielőtt a felhasználó érzékeli
- Kevés, értelmes, SLO-alapú riasztás
- Minden jelzés egy helyen, összekötve
- Okelemzés és megelőző javítás
Kinek ajánljuk?
Online értékesítés
A fizetés és a kosár folyamatos figyelése.
Szolgáltatás ügyfeleknek
SLA-teljesítés és riport az ügyfeleknek.
ERP, CRM, portál
Megfigyelés és riasztás a kritikus folyamatokra.
Konténerplatform
Klaszter- és alkalmazásszintű megfigyelés.
Bank, egészségügy
Dokumentált incidenskezelés, auditnapló.
Kész megfigyelés
Átadjuk, vagy az AWS-felügyelet csomagban üzemeltetjük.
Saját projektünk
Felméréstől a modernizált AWS-környezetig
Kihívás
Nehezen átlátható, növekvő infrastruktúra.
Megoldás
Infrastruktúra-felmérés, havi üzemeltetés, költözés.
Cél
Lépésenként modernizált, kiszámítható környezet.
Amiből építkezünk
Gyűjtés
- OpenTelemetry
- Amazon CloudWatch
- Fluent Bit
Tárolás és nézet
- Prometheus
- Grafana
- Amazon OpenSearch
Riasztás
- Alertmanager
- CloudWatch Alarms
- Microsoft Teams
Automatizmus
- AWS Systems Manager
- AWS Lambda
- Runbookok
Megbízható üzemeltetés
- Titkosított jelzésgyűjtés (TLS, KMS)
- Hozzáférés szerepkörök szerint, naplózva
- Dokumentált incidenskezelés
- Dokumentált riasztási és eszkalációs rend
Gyakori kérdések
Ügyeletet is vállalnak?
A megfigyelést munkaidős és 24/7 működéshez is kiépítjük. A folyamatos ügyeletet és a vállalt reakcióidőket az AWS-felügyelet (Bronze, Silver, Gold) csomagjaink adják; a kiépítés után a felügyelet a csapatánál is maradhat.
A meglévő monitoringunkra épülhet?
Igen. Ha már van CloudWatch, Datadog, Zabbix vagy Prometheus, arra építünk, és csak a hiányzó részeket egészítjük ki.
Mi az SLO?
Szolgáltatási szintű cél: például hogy a fizetés a kérések 99,9%-ában 300 ms alatt válaszoljon. A riasztás ehhez igazodik, így a felhasználói élményt védi, nem az egyes szervereket.
Ki javítja a hibát?
Az ismert hibákat automatikus runbook javítja; a többit a csapata – vagy, ha az üzemeltetést ránk bízza, az ügyeletes mérnökünk a csomag szerinti reakcióidővel.
Kapcsolódó olvasnivaló
Beszéljük át az Ön helyzetét
Egy kötelező kérdés, a neve és az e-mail-címe – a többi mező nem kötelező.
- Átnézzük a válaszait.
- Kollégánk felveszi Önnel a kapcsolatot, és egy rövid hívásban pontosítjuk a célokat.
- Konkrét javaslatot adunk az első lépésre.